
 हिन्दी
expand_more
 English
 Español
 Deutsch
 Français
 Português
 Türkçe
 Polski
 العربية
Labrika में JavaScript साइट की SEO त्रुटियाँ कैसे जाँचें
कैटलॉग React या Vue पर ले जाने के बाद उत्पाद ब्राउज़र में सही दिख सकते हैं, फिर भी उनके शीर्षक एक जैसे, canonical गलत या लिंक बिना URL के हो सकते हैं। Labrika का JavaScript मोड स्क्रिप्ट चलने के बाद का कंटेंट जाँचता है और डेवलपर के लिए ठोस URL जुटाता है। नया टेम्पलेट स्वीकार करते समय और डायनेमिक साइट का SEO शुरू करने से पहले यह उपयोगी है।
JavaScript प्रोसेसिंग चालू करें
साइट सेटिंग → «उन्नत सेटिंग्स» → «क्रॉलर सेटिंग्स» खोलें। «जावास्क्रिप्ट पार्स करें (प्रत्येक पृष्ठ के लिए 1 के बजाय 2 पृष्ठ पार्सिंग क्रेडिट काटे जाएंगे)» चालू करके सहेजें।
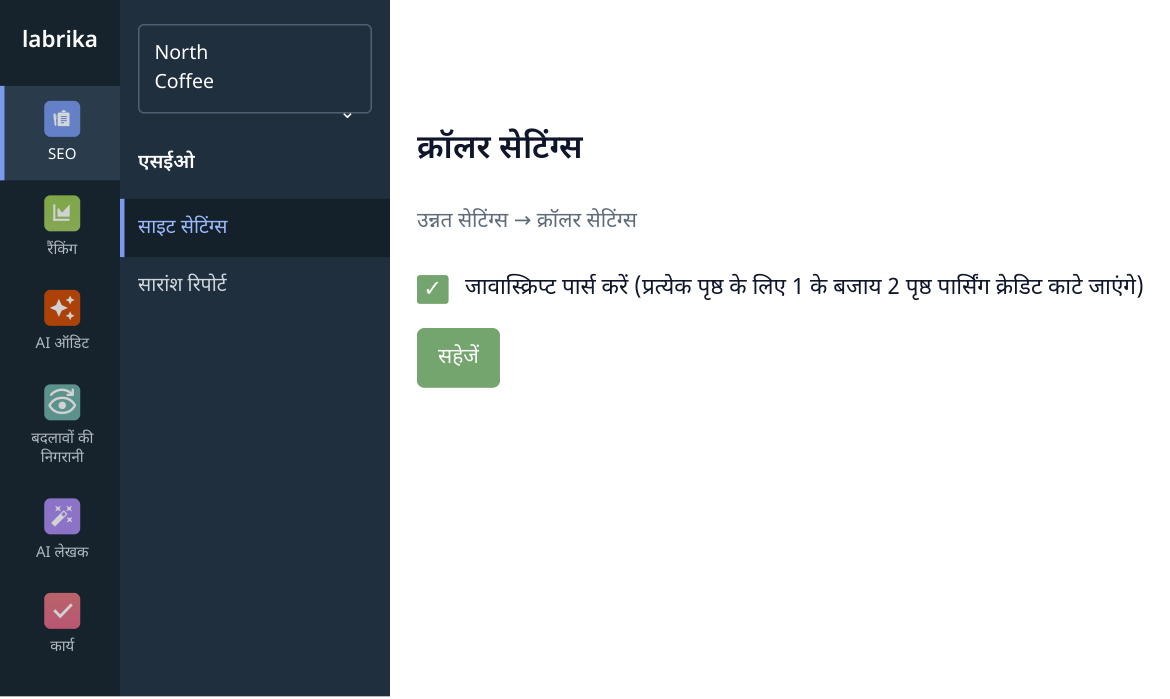
1. «एसईओ» → «साइट सेटिंग्स» से शुरू करें। «उन्नत सेटिंग्स» में क्रॉलिंग सेटिंग खोलें, JS चालू करें और सहेजें। यह इंटरफ़ेस का हिस्सा है; उदाहरण के आँकड़े काल्पनिक हैं।
यह मोड तब चाहिए जब महत्वपूर्ण कंटेंट स्क्रिप्ट से बनता है। सर्वर पहले से तैयार शीर्षक, लिंक और टेक्स्ट देता हो, तो केवल React या Vue इस्तेमाल होने से हर ऑडिट में JS चालू करना ज़रूरी नहीं होता।
जाँच के फ़ोल्डर और अपवाद तय करें
इन्हीं «क्रॉलर सेटिंग्स» में दो सूचियाँ हैं: «URL प्रतिबंध» और «यूआरएल अपवाद»। इनसे ज़रूरी सेक्शन जाँचें और गैरज़रूरी पेज छोड़ें। जैसे React कैटलॉग अपडेट होने के बाद उत्पाद और एक्सेसरी जाँचें, लेकिन तुलना पेज और क्रम बदलने वाले URL हटाएँ। इससे JS जाँच के क्रेडिट उन्हीं पेजों पर लगते हैं जिनका SEO कर रहे हैं।
जाँच में ज़रूरी फ़ोल्डर जोड़ें
«URL प्रतिबंध» में हर पथ नई पंक्ति पर दें, जैसे /coffee/ और /accessories/। पूरा URL भी दे सकते हैं, जैसे https://shop.example/coffee/। Labrika उन्हीं URL से क्रॉल शुरू करके उन फ़ोल्डरों में मिले पेज जाँचेगी: /coffee/ का नियम /coffee/model-a पर भी लागू है।
फ़ोल्डर के अंदर के पेज भी जाँचने के लिए «अन्य सभी पृष्ठों को छोड़ें» बंद रखें। केवल सूची के सटीक URL चाहिए, जैसे टेम्पलेट सुधार के बाद कुछ उत्पाद पेज, तो इसे चालू करें और उन पेजों के URL दें।
गैरज़रूरी पेज हटाएँ
«यूआरएल अपवाद» में भी एक नियम प्रति पंक्ति दें। जैसे /coffee/compare/ उस फ़ोल्डर के तुलना पेज हटाएगा, और *sort=* से sort= पैरामीटर वाले URL हटेंगे। यहाँ robots.txt जैसे नियम इस्तेमाल होते हैं; अपवाद चुने हुए जाँच फ़ोल्डरों के भीतर भी लागू रहते हैं।
पूरी साइट जाँचनी हो और केवल कुछ सेक्शन छोड़ने हों, तो «URL प्रतिबंध» खाली रखकर सिर्फ अपवाद भरें। कुछ खास सेक्शन और उनके भीतर अपवाद चाहिए, तो नीचे के उदाहरण की तरह दोनों सूचियाँ भरें।
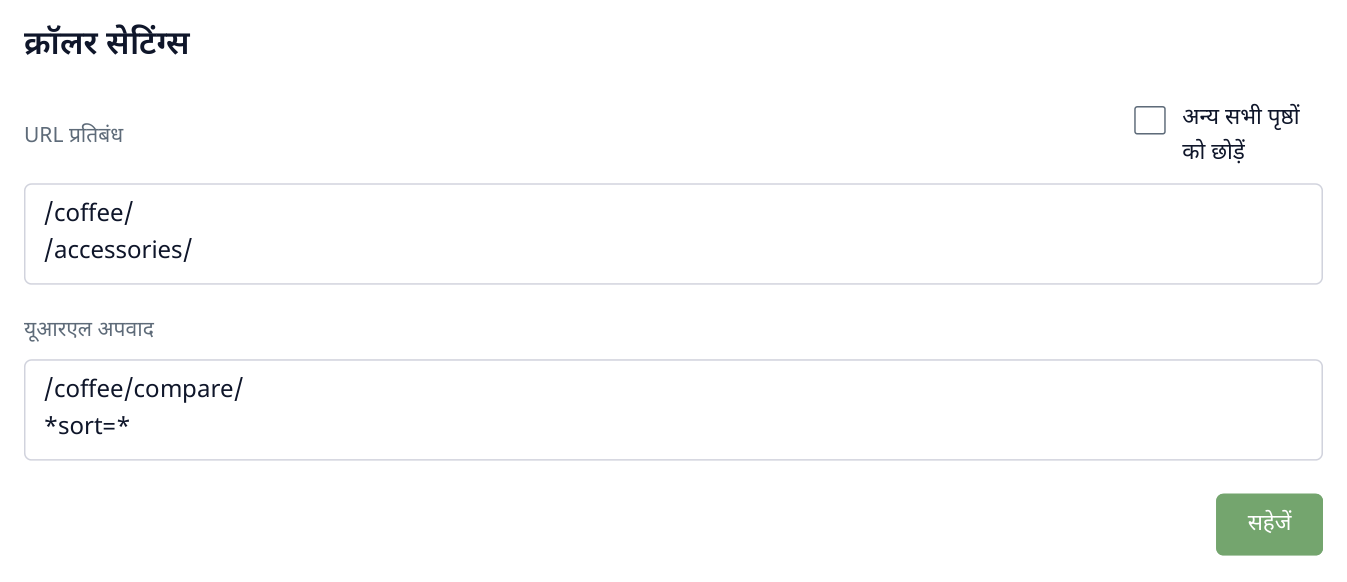
2. उदाहरण: दो फ़ोल्डर और उनके भीतर के पेज जाँचे जाते हैं; उत्पाद तुलना और sort= वाले URL छोड़े जाते हैं। चेकबॉक्स बंद है, ताकि क्रॉल ऊपरी सूची के केवल दो URL तक सीमित न रहे।
«सहेजें», फिर «रिपोर्ट शुरू करें» दबाकर पूरा ऑडिट चलाएँ। उदाहरण के नतीजों में /coffee/ और /accessories/ के पेज तथा मिले उत्पाद शामिल होंगे; तुलना और सॉर्टिंग पेज बाहर रहेंगे। ज़रूरी उत्पाद दूसरे फ़ोल्डर, जैसे /products/, में हो, तो वह पथ भी जोड़ें।
ऐप से बनने वाले तत्व जाँचें
«SEO ऑडिट» → «TITLE डुप्लिकेट्स» और «मेटा टैग और h1 त्रुटियाँ» से शुरू करें। जैसे बीस उत्पादों का Title «कैटलॉग» रह गया है, जबकि स्क्रीन पर अलग नाम हैं। URL की सूची डेवलपर को दें: टेम्पलेट में हर उत्पाद के डेटा से Title बनना चाहिए। फिर «तकनीकी ऑडिट» → «rel=canonical टैग वाले पृष्ठ» में जाँचें कि उत्पाद अपने चुने मुख्य URL पर जाते हैं, सभी कैटेगरी पर नहीं।
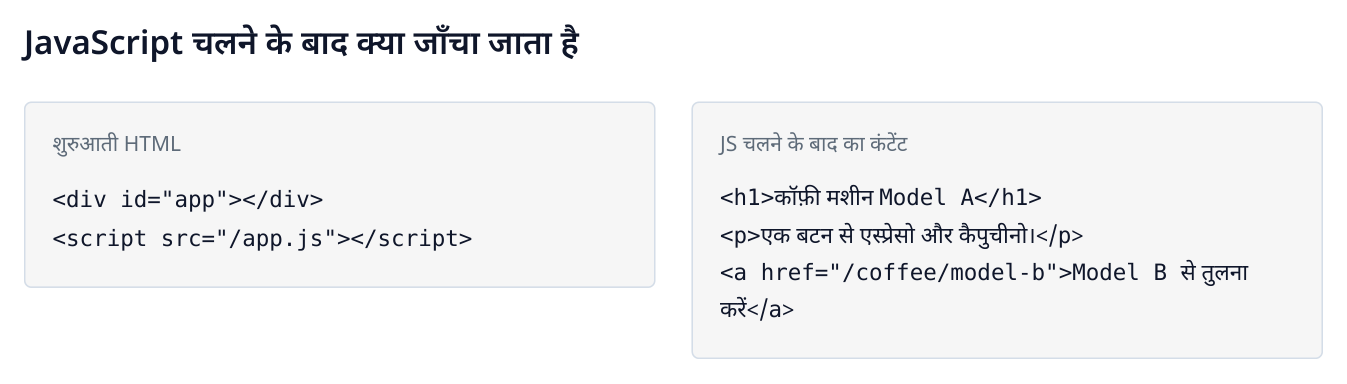
3. समझाने के लिए उदाहरण: स्क्रिप्ट चलने के बाद शीर्षक, विवरण और दूसरे उत्पाद का लिंक दिखाई देते हैं।
«लिंक्स» में «आंतरिक लिंक» खोलें और कैटेगरी से उत्पादों तक लिंक जाँचें। उत्पाद केवल JavaScript हैंडलर से खुलता हो, तो डेवलपर से सामान्य URL वाला लिंक जोड़ने को कहें: <a href="/coffee/model-a">Model A</a>। Google पेज खोजने के लिए href वाले लिंक सुझाता है; देखें JavaScript SEO दस्तावेज़।
सुधार के बाद वही JS सेटिंग और वही क्रॉलिंग दायरा रखकर दोबारा जाँचें। टेम्पलेट सही चले, तो पूरे ज़रूरी कैटलॉग तक ऑडिट बढ़ाएँ।
दोबारा वही रिपोर्ट खोलें: साझा Title डुप्लिकेट से हटना चाहिए, canonical सही पेजों पर और लिंक नेविगेशन में मिलने चाहिए। रिलीज़ स्वीकार करने के लिए नतीजे सहेजें और इसी टेम्पलेट वाली बाकी कैटेगरी भी जाँचें।